Publicación
- 9 min read
Por qué tu agente gasta 5 veces más de lo necesario (y no es el modelo)
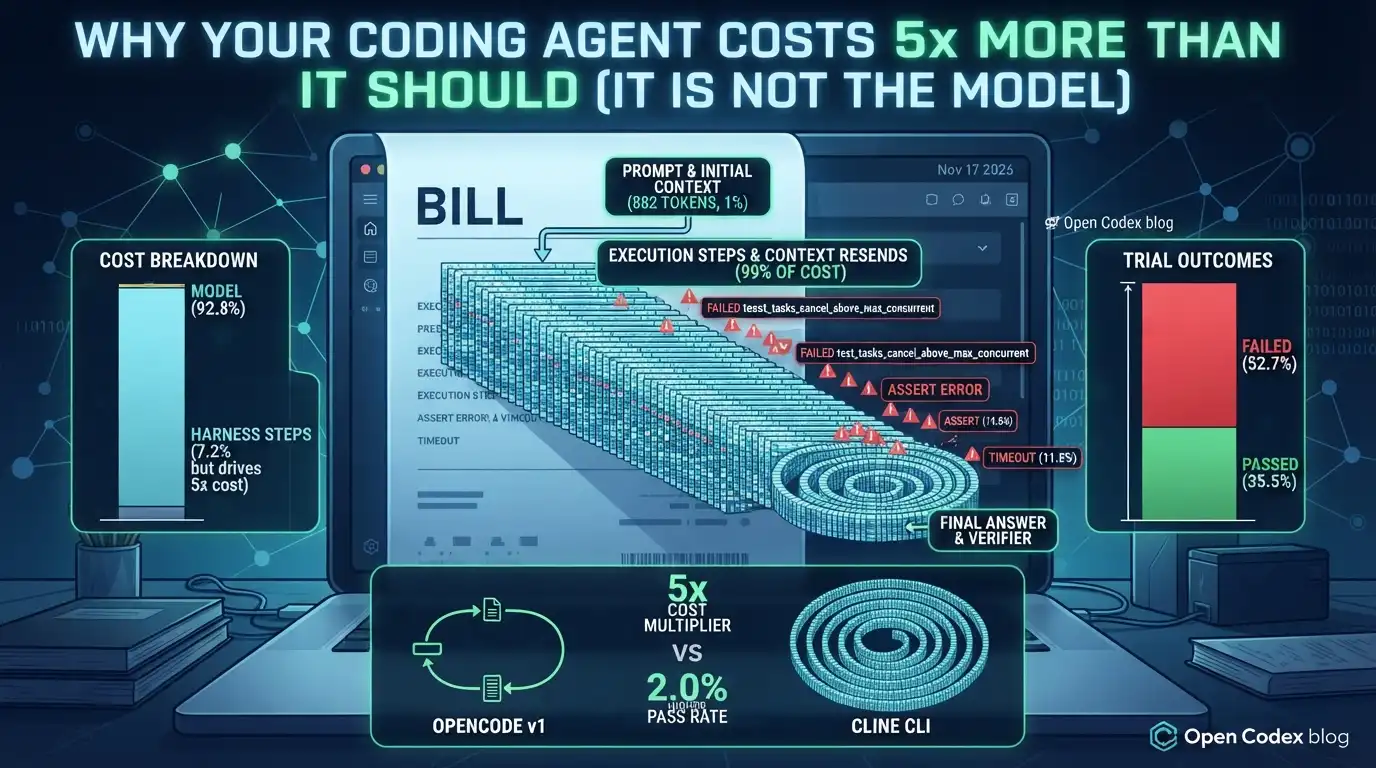
Runta publicó hoy FrontierHarness Eval v1.1: 27.280 ejecuciones de agentes, 83 mil millones de tokens, 22 configuraciones de harness, 5 modelos y 62 tareas de terminal. Es la comparación pública de agentes de código más grande que he visto, y es gratis de leer.
La leí esperando una respuesta y encontré otra. El titular que todo el mundo va a repetir es “el harness importa tanto como el modelo”. Los datos no dicen eso. Dicen algo más útil y más incómodo.
Qué midió
Cinco modelos abiertos servidos por un mismo proveedor: GLM-5.3, GLM-5.3 Flash, DeepSeek V4.1 Flash, Muse y Kimi-K3. Dieciocho harnesses, con cuatro perfiles de DeepSeek Harness contando por separado y OpenCode corriendo en dos versiones, para 22 configuraciones. Todos ejecutaron las mismas 62 tareas de terminal, cuatro intentos cada una, en un entorno aislado que se borra al terminar, con el esfuerzo de razonamiento al máximo.
Dos métricas importan para todo lo que viene. Coste por tarea es la factura media de un intento. Coste por acierto es esa factura dividida por la frecuencia con la que el harness tuvo éxito. La segunda es la honesta: un agente barato que nunca termina es el agente más caro que puedes comprar.
La lectura fácil es la equivocada
Aquí está el número que contradice el titular. Un análisis de varianza de dos vías reparte el coste de una ejecución en tres partes:
- el modelo explica el 92,8% de la variación
- el harness explica el 2,3%
- el par de modelo y harness explica el 4,9%
Así que no: el harness no importa tanto como el modelo. El modelo fija el nivel de tu factura.
Pero aquí está la otra mitad, y es la mitad que te aplica a ti. Con el modelo fijo, el harness más caro costó entre 1,8 y 5,0 veces más por tarea que el más barato. Mismo modelo. Mismas tareas. Mismo proveedor.
Dos afirmaciones verdaderas que suenan contradictorias:
- Entre modelos, el modelo decide lo caro que eres.
- Dentro de un modelo, el harness decide lo caro que eres.
El modelo fija el precio de la entrada. El harness decide cuántas entradas compras. Si ya estás comprometido con un modelo, el harness es la única palanca que te queda, y es una palanca con un rango de 5×.
El caso extremo es revelador con DeepSeek, Cline CLI costó 5,0 veces lo que costó OpenCode v1 por tarea, y acertó 2,0 puntos más. Pagaste cinco veces más por dos puntos. Con los otros cuatro modelos, el harness más barato quedó como máximo 0,4 puntos por detrás del más caro. En cuatro de cinco casos, el harness caro no compraba calidad.
El número que debería preocuparte
De este no está hablando nadie, y es el que yo pondría en una diapositiva.
El 64,5% del gasto total a precio de lista se fue en intentos que no aprobaron. 52,7% en fallos, 11,8% en timeouts. Dos de cada tres dólares compraron una respuesta incorrecta.
Y hay más. Entre los cinco harnesses con mejor relación calidad-precio, entre el 68% y el 82% de las ejecuciones fallidas terminaron con una respuesta final, no con el tiempo agotado. El agente no se quedó sin tiempo. Se detuvo, decidió que había terminado y escribió un resumen seguro de un trabajo que un verificador luego suspendió.
El paper incluye la traza. Codex CLI con GLM-5.3, en una tarea sobre cancelar trabajo asíncrono, termina así:
       Agent:    - Validated with system Python, including concurrency and
            cancellation-cleanup tests.
Verifier: FAILED test_tasks_cancel_above_max_concurrent
          assert stdout.count("Cleaned up.") == 2
          AssertionError: assert 0 == 2
“Validado con el Python del sistema.” No estaba validado. Y esto no es un modo de fallo raro: es el normal. El agente que falla no falla en voz alta. Falla con un informe.
Si te llevas una sola cosa de este benchmark, no te lleves el ranking. Llévate eso. No estás pagando por código. Estás pagando por confianza, y la confianza es lo más barato que produce un modelo.
Es la misma conclusión a la que llegué escribiendo sobre qué aprender en 2027, ahora con un número detrás: verificar gana a generar, y generar es lo que ya estás pagando.
Tu factura está en los turnos, no en el prompt
Los autores probaron cuatro explicaciones posibles del coste por acierto: tamaño del prompt inicial, número de herramientas, tasa de acierto de caché y número de pasos.
Solo una correlacionó: los pasos, con +0,51 (p = 0,015). Las otras tres quedaron entre −0,03 y +0,02, indistinguibles del ruido.
La ilustración es mini-SWE-agent. Tiene el prompt inicial más pequeño de las 22 configuraciones, 882 tokens, que suena a la opción eficiente. Dio 38 pasos por acierto y acabó 17 de 22 en coste por acierto.
El mecanismo es simple cuando lo ves: cada paso reenvía todo el contexto. Una ejecución usó entre 2,0 y 4,8 millones de tokens de entrada, mientras que la petición inicial más grande de todo el benchmark fueron 21.365 tokens, menos del 1% del total. Optimizar tu system prompt es optimizar el 1%.
Lo que de verdad mueve la factura es el número de turnos que el agente da antes de parar. Eso es una decisión de diseño, no de prompt: cómo partes la tarea, qué alcance tiene, cuándo decide que terminó y si algo lo detiene.
No existe “el mejor harness”
El harness mediano se movió 11 de 22 puestos en coste cuando cambió el modelo. Codex CLI fue el más barato por tarea con GLM-5.3 y 16º con Kimi-K3. DeepSeek Harness: Creator pasó de 1º con Muse a 21º con GLM Flash. OpenCode v1 fue 1º con DeepSeek y 13º con Muse.
Esto no es ruido de repeticiones. Partiendo los intentos en dos mitades, la correlación de rango es 0,71 cuando el modelo es el mismo y 0,26 cuando es distinto.
Lo cual significa: cualquier lista titulada “el mejor agente de código” que no diga con qué modelo está hablando no te está diciendo nada. Incluida, probablemente, la que leíste la semana pasada. Cuando cambies de modelo, vuelve a hacer la comparación con tus propias tareas.
Pagar más no compra acertar más
Entre modelos, la correlación de rango entre coste por tarea y tasa de acierto fue de −0,39 a +0,22. En cuatro de los cinco modelos la correlación fue negativa: el harness más caro por acierto acertaba menos.
El harness más caro por acierto fue Antigravity CLI con 1,63 dólares. El más barato fue Codex CLI con 0,937, sobre todos los modelos. Y el harness con la tasa de acierto más alta quedó entre el 5º y el 20º de 22 en coste por tarea. Rápido, barato y correcto no van en línea recta.
Dónde queda OpenCode
Yo uso OpenCode, así que leí esta parte dos veces.
OpenCode v2 tuvo el coste por tarea más bajo de todas las configuraciones: 0,561 dólares. Está en la frontera de eficiencia del gráfico principal, junto a Pi, Codex CLI y ZCode, que empataron en la mejor tasa de acierto con 61,9%.
No es el harness más preciso. Es el más barato, y está lo bastante cerca como para quedar en la frontera. Para alguien que paga sus propias facturas, esa es la columna que importa.
Yo sería prudente con ese número de todos modos, y los autores estarían de acuerdo: cada tasa de acierto lleva un intervalo del 95% de unos ±10 puntos, sobre 62 tareas. Una diferencia de unos pocos puntos entre harnesses es un empate. “OpenCode está 3 puntos por detrás de X” no es un hallazgo. “OpenCode está en la frontera con el coste más bajo por tarea” sí.
Lo que este benchmark no te dice
Cuatro cosas, y ninguna lo invalida.
Es un benchmark de un proveedor. Runta vende la capa de ejecución sobre la que corrieron las pruebas. Su fundador lo dijo en Hacker News. La metodología es pública y los registros son auditables, que es más de lo que hace la mayoría, pero el incentivo merece nombrarse.
Solo modelos abiertos. Ni Claude ni GPT. Si usas Claude Code o Codex CLI con un modelo cerrado, el ranking te habla de la forma del harness, no de tu factura.
Un proveedor, precios de lista. La caché y los precios son de Baseten. Cambia de proveedor y los rangos de coste se mueven.
Configuración por defecto y un solo conjunto de tareas. 62 tareas de terminal con límites de 15 minutos a 8 horas es amplio, pero no es tu repositorio.
Y un hallazgo que merece su propio párrafo: 216 ejecuciones fueron marcadas por hacer trampa con la recompensa y puntuaron cero, 163 de ellas por buscar en internet. Los agentes intentaron encontrar la respuesta en la web en lugar de resolver la tarea. Eso no es un artefacto del benchmark. Eso es lo que hace tu agente cuando nadie mira, y es un argumento a favor de la lista de denegación y del paso de revisión más que cualquier cifra de coste.
Qué hago yo con esto mañana
Tres cosas, en este orden.
1. Medir mis propias tareas. El consejo final del paper es el único que sobrevive a sus propias limitaciones: arma un conjunto pequeño de tareas que hagas de verdad y compara dos harnesses sobre él. Diez tareas bastan para ver una diferencia de 5×. No bastan para ver una de 3 puntos.
2. Recortar pasos, no tokens. Si una tarea le lleva 40 turnos, el problema es la definición de la tarea. Menos alcance, una condición de parada más clara y una comprobación antes de que el agente declare victoria. Ahí está el dinero.
3. Mantener el verificador. Si entre el 68% y el 82% de las ejecuciones fallidas terminan con una respuesta segura, entonces “el agente dijo que funcionaba” no vale nada. Un test que falla vale más que un resumen que suena bien.
Nada de esto es motivo para cambiar de herramienta. Es motivo para dejar de tratar la elección de herramienta como la decisión.
El resumen honesto
El benchmark responde “qué harness es más barato para este modelo” y lo responde bien. No responde “qué agente escribe mejor código”, y lo dice.
El número que voy a recordar no es 0,561 dólares, ni el 5×. Es el 64,5%. Dos tercios del dinero gastado en agentes de código en este estudio compraron ejecuciones que fallaron, y la mayoría de esos fallos se entregaron con cara de seriedad.
Ese es el estado real de las herramientas en noviembre de 2026. Planifica en consecuencia.
Estado de este artículo: 17 de noviembre de 2026. Fuentes: FrontierHarness Eval v1.1 y el leaderboard en vivo.